On a tous connu le projet qui démarre directement par le code. Ça avance vite la première semaine. Puis une question arrive : « un commentaire peut-il exister sans compte ? ». Personne ne l'avait posée, la base ne le permet pas et il faut tout reprendre.
La conception sert à poser ces questions avant qu'elles ne coûtent cher. Ce n'est pas de la paperasse. C'est la façon la moins chère de se tromper.
Cet article suit un seul exemple du début à la fin : un blog avec des visiteurs, des membres et un administrateur. On part du besoin exprimé en user stories et on arrive au script SQL qui crée les tables.
Une chaîne, pas une liste d'outils
Chaque étape répond à une question précise et nourrit la suivante.
| Étape | Question | Livrable |
|---|---|---|
| User story | Qu'est-ce que l'utilisateur veut et pourquoi ? | Une phrase et des critères d'acceptation |
| Cas d'utilisation | Qui fait quoi avec le système ? | Un diagramme et des scénarios |
| Diagramme de séquence | Comment les éléments échangent pour y arriver ? | Un diagramme par scénario important |
| MCD | Quelles données et quels liens entre elles ? | Entités, associations, cardinalités |
| MLD | Comment ranger ces données en tables ? | Tables, clés primaires et étrangères |
| MPD | Comment l'écrire pour ce SGBD précis ? | Le script SQL |
Les trois premières étapes viennent d'UML et des méthodes agiles. Les trois dernières viennent de Merise. On les mélange tous les jours en entreprise et c'est très bien comme ça.
La user story
Le format
Une user story décrit un besoin du point de vue de celui qui en profite.
En tant que <rôle>,
je veux <action>,
afin de <bénéfice>.
Trois exemples pour notre blog.
En tant que visiteur,
je veux rechercher un article par mot-clé,
afin de trouver rapidement un sujet qui m'intéresse.

En tant que membre,
je veux modifier mon commentaire pendant quelques minutes,
afin de corriger une faute de frappe.

En tant qu'administrateur,
je veux être prévenu par email d'un commentaire en attente,
afin de le modérer rapidement.
La troisième partie « afin de » est celle qu'on oublie le plus. C'est pourtant la plus utile. Elle explique pourquoi on fait le travail, ce qui permet de proposer une meilleure solution que celle demandée.
Les critères d'acceptation
Une story sans critères d'acceptation ne peut pas être terminée, puisque personne ne sait à quoi ressemble « fini ». La forme la plus répandue vient de Gherkin : Étant donné, Quand, Alors.
Scénario : modifier son commentaire à temps
  Étant donné un membre connecté qui a publié un commentaire il y a 5 minutes
  Quand il modifie le texte et enregistre
  Alors le nouveau texte remplace l'ancien

Scénario : délai dépassé
  Étant donné un membre connecté qui a publié un commentaire il y a 20 minutes
  Quand il affiche l'article
  Alors le bouton « Modifier » n'apparaît plus sur ce commentaire
Chaque scénario devient presque mot pour mot un test automatisé. C'est le vrai intérêt du format.
Une bonne story respecte INVEST
- Indépendante : elle peut être livrée sans attendre une autre
- Négociable : c'est le début d'une discussion, pas un contrat figé
- Valeur : elle apporte quelque chose à un utilisateur
- Estimable : l'équipe sait dire à peu près combien elle coûte
- Small (petite) : elle tient dans une itération
- Testable : on sait vérifier qu'elle est faite
Les pièges
La story technique déguisée.
En tant que développeur,
je veux créer la table comments,
afin de stocker les commentaires.
Aucun utilisateur ne profite d'une table. C'est une tâche, elle a sa place sous une vraie story.
La story trop grosse « En tant que membre, je veux gérer mon compte » cache une inscription, une connexion, un changement de mot de passe et une suppression. C'est une epic. Il faut la découper.
Le diagramme de cas d'utilisation
Ce qu'il montre
Il donne une vue d'ensemble : qui utilise le système et pour faire quoi. Il ne montre ni les écrans, ni l'ordre des actions, ni les données.
Ses éléments :
- l'acteur : un rôle extérieur au système, humain ou non. « Visiteur », pas « Paul »
- le cas d'utilisation : un objectif de l'acteur formulé avec un verbe à l'infinitif
- le cadre : la limite du système
- les relations : association, généralisation, inclusion et extension
L'exemple
Un bonhomme pour chaque acteur, une ellipse pour chaque cas et une flèche à triangle pour l'héritage.
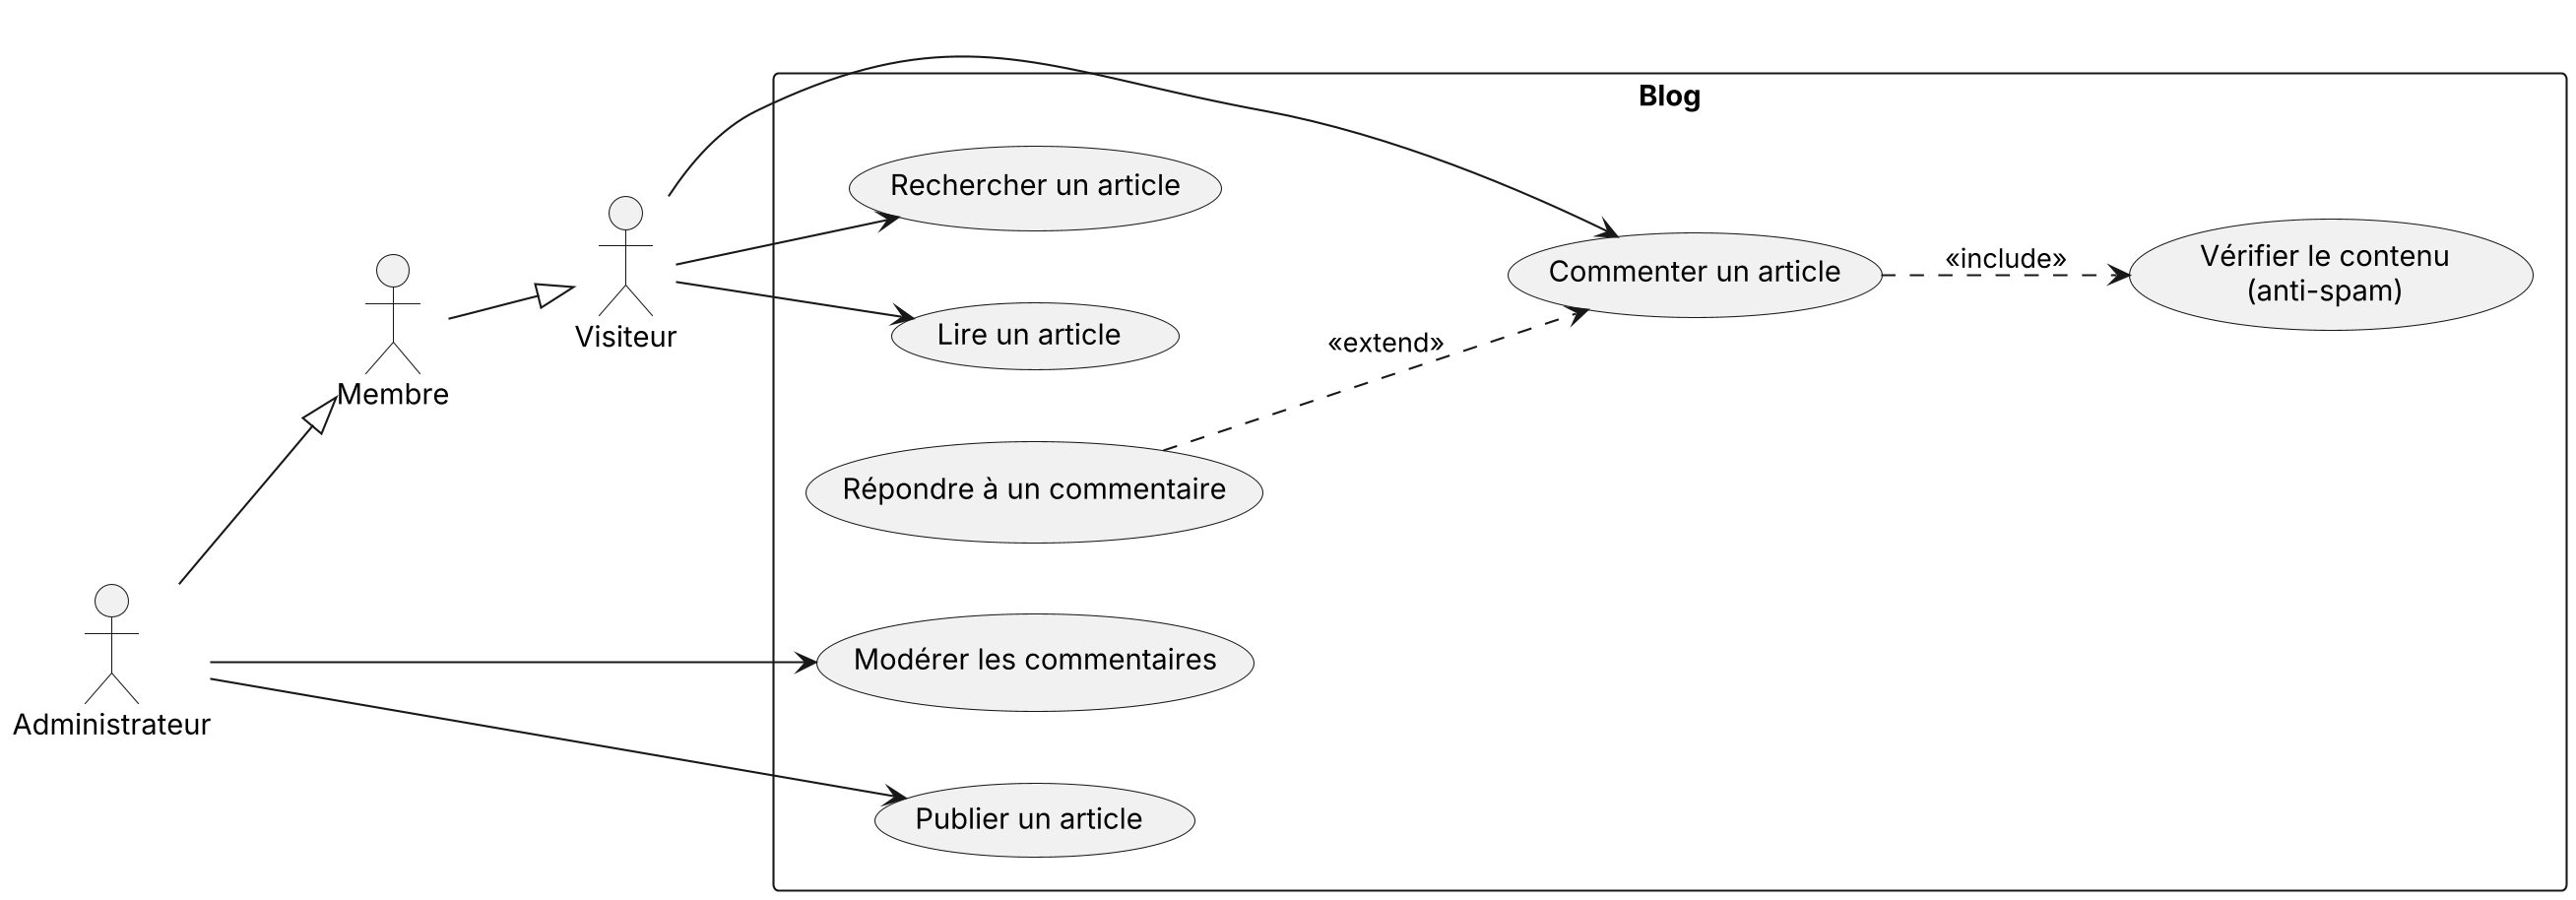
Son code source, à coller tel quel sur le site de PlantUML ou dans un plugin d'IDE :
@startuml
left to right direction

actor Visiteur
actor Membre
actor Administrateur

Membre --|> Visiteur
Administrateur --|> Membre

rectangle "Blog" {
  usecase "Lire un article" as UC1
  usecase "Rechercher un article" as UC2
  usecase "Commenter un article" as UC3
  usecase "Répondre à un commentaire" as UC4
  usecase "Vérifier le contenu\n(anti-spam)" as UC5
  usecase "Modérer les commentaires" as UC6
  usecase "Publier un article" as UC7
}

Visiteur --> UC1
Visiteur --> UC2
Visiteur --> UC3
Administrateur --> UC6
Administrateur --> UC7

UC3 ..> UC5 : <<include>>
UC4 ..> UC3 : <<extend>>
@enduml
Les relations, sans contresens
La généralisation se lit « est un ». Un membre est un visiteur. Il peut donc faire tout ce que fait un visiteur, plus ses propres actions. Inutile de relier le membre à « Lire un article », c'est hérité.
L'inclusion (include) désigne un comportement toujours exécuté par le cas de base. Commenter déclenche toujours la vérification anti-spam. La flèche part du cas de base vers le cas inclus.
L'extension (extend) désigne un comportement optionnel,qui ne se produit que sous condition. Répondre à un commentaire est une variante de « commenter », utilisée seulement quand on vise un message précis. La flèche part de l'extension vers le cas de base.
L'erreur la plus fréquente consiste à découper un cas en étapes avec des include : « saisir le texte », « cliquer sur envoyer », « afficher le message ». Ce n'est plus un diagramme de cas d'utilisation, c'est un organigramme mal dessiné. Le déroulé d'un cas se décrit ailleurs.
La description textuelle
Le diagramme ne suffit pas. Chaque cas important s'accompagne d'une fiche.
Cas : Commenter un article
Acteur principal : Visiteur
Précondition : l'article est publié

Scénario nominal
  1. Le visiteur saisit son nom, son email et son commentaire
  2. Le système vérifie le contenu (anti-spam)
  3. Le système enregistre le commentaire en attente de modération
  4. Le système prévient l'administrateur par email
  5. Le système affiche un message de confirmation

Scénarios alternatifs
  2a. Le contenu est refusé : le système affiche le formulaire avec l'erreur
  3a. L'acteur est un membre connecté : le commentaire est publié directement

Postcondition : le commentaire existe en base
Le diagramme de séquence
Ce qu'il montre
Il prend un scénario et montre qui envoie quel message à qui, dans quel ordre. Le temps s'écoule de haut en bas.
Ses éléments :
- la ligne de vie : un participant, avec un trait vertical en dessous
- le message synchrone (flèche pleine,
->>en Mermaid) : l'émetteur attend la réponse - le message asynchrone (flèche ouverte,
-)) : l'émetteur n'attend pas. Un email mis en file d'attente par exemple - le retour (flèche en pointillés,
-->>) : la réponse à un message - la barre d'activation : la période où le participant travaille. En Mermaid, un
+ou un-collé à la flèche l'ouvre ou la ferme - les fragments :
altpour une alternative,optpour une option,looppour une boucle
L'exemple
Mermaid, qui dessine les autres diagrammes de cet article ne connaît pas le diagramme de cas d'utilisation. Celui-ci est donc dessiné avec PlantUML, un outil qui respecte la notation UML : un bonhomme pour chaque acteur, une ellipse pour chaque cas et une flèche à triangle pour l'héritage.
sequenceDiagram
    actor Membre
    participant Nav as Navigateur
    participant Router as Routeur Laravel
    participant Req as StoreCommentRequest
    participant Ctrl as BlogController
    participant Model as Comment
    participant DB as Base de données
    participant Mail as Service de mail

    Membre->>Nav: envoie le formulaire
    Nav->>+Router: POST /blog/{slug}/comment
    Router->>+Req: valider les données

    alt données invalides
        Req-->>Nav: 302 vers le formulaire + erreurs
    else données valides
        Req-->>-Router: données validées
        Router->>+Ctrl: addComment(request, slug)
        Ctrl->>Model: create(données)
        Model->>DB: INSERT INTO comments
        DB-->>Model: id
        Model-->>Ctrl: Comment

        opt réponse à un commentaire
            Ctrl->>Mail: prévenir l'auteur visé
        end

        Ctrl-->>-Nav: 302 vers l'article + message
    end

    deactivate Router
Un détail montre l'intérêt de l'exercice. En Laravel, la validation d'une FormRequest a lieu avant l'appel du contrôleur. Quand les données sont invalides, le contrôleur n'est jamais exécuté. Dessiner la séquence oblige à le savoir.
Le bon niveau de détail
Un diagramme de séquence n'est pas du code dessiné. On n'y met ni les getters, ni chaque appel de fonction. On garde les échanges qui comptent pour comprendre le scénario et on en fait un par scénario important, pas un par méthode.
Merise : du MCD au MPD
Merise est une méthode française, née à la fin des années 1970. Elle sépare la conception d'une base de données en trois niveaux.
- Conceptuel (MCD) : quelles données, sans penser à la technique
- Logique (MLD) : comment les ranger dans des tables
- Physique (MPD) : comment les écrire pour un SGBD précis
Chaque niveau se déduit du précédent avec des règles simples. C'est ce qui rend la méthode si pratique.
Le dictionnaire de données
Avant de dessiner, on liste les informations à stocker avec leur type et leurs contraintes.
| Donnée | Type | Contrainte |
|---|---|---|
| pseudo | texte, 30 caractères | obligatoire, unique |
| texte, 255 caractères | obligatoire, unique | |
| titre | texte | obligatoire |
| contenu du commentaire | texte long | obligatoire |
| date de publication | date et heure | facultative |
| libellé du tag | texte, 50 caractères | obligatoire, unique |
On en profite pour chasser les données calculées. Le nombre de commentaires d'un article ne se stocke pas : il se compte.
Le MCD
Le MCD contient trois sortes d'éléments.
- L'entité : un objet du domaine avec ses propriétés. UTILISATEUR, ARTICLE
- L'identifiant : la propriété qui distingue chaque occurrence. id_article
- L'association : un lien entre entités nommé par un verbe. ÉCRIRE, CONCERNER
Notre MCD, sous forme textuelle :
UTILISATEUR (id_utilisateur, pseudo, email, mot_de_passe)
ARTICLE     (id_article, titre, contenu, date_publication)
COMMENTAIRE (id_commentaire, contenu, date_creation)
TAG         (id_tag, libelle)

UTILISATEUR 0,n ---- ÉCRIRE ---- 0,1 COMMENTAIRE
ARTICLE     0,n ---- CONCERNER - 1,1 COMMENTAIRE
ARTICLE     0,n ---- ÉTIQUETER - 0,n TAG
UTILISATEUR 0,n ---- AIMER ----- 0,n ARTICLE
                     (date_aime)
Lire les cardinalités
Les cardinalités se placent à côté de chaque entité. Elles disent combien de fois une occurrence de cette entité participe à l'association, au minimum puis au maximum.
| Cardinalité | Sens |
|---|---|
| 0,1 | au plus une fois, peut-être jamais |
| 1,1 | exactement une fois |
| 0,n | autant de fois qu'on veut, peut-être jamais |
| 1,n | au moins une fois |
On lit toujours depuis l'entité vers l'association :
- un utilisateur écrit 0 à n commentaires
- un commentaire est écrit par 0 ou 1 utilisateur
Ce 0,1 n'est pas une erreur. Sur notre blog, un visiteur peut commenter sans compte. Le commentaire n'a alors aucun utilisateur. C'est exactement la question du début de l'article et le MCD l'a posée avant qu'une seule table existe.
À l'inverse, un commentaire concerne exactement un article (1,1). Un commentaire sans article n'a pas de sens.
Attention si tu viens d'UML : dans un diagramme de classes, les multiplicités se placent de l'autre côté de l'association. Le sens est le même, seule la position change.
L'association porteuse de données
AIMER porte une propriété : la date à laquelle le membre a aimé l'article. Cette date n'appartient ni à l'utilisateur, ni à l'article. Elle appartient au couple des deux. C'est le signe qu'elle doit vivre dans l'association.
Le MLD : trois règles de passage
Règle 1. Chaque entité devient une table. Son identifiant devient la clé primaire.
Règle 2. Une association avec un côté x,1 et un côté x,n disparaît. L'identifiant de l'entité côté x,n part comme clé étrangère dans la table côté x,1.
- côté 1,1 : la clé étrangère est obligatoire (NOT NULL)
- côté 0,1 : la clé étrangère est facultative (NULL autorisé)
Règle 3. Une association x,n des deux côtés devient une table. Sa clé primaire est composée des deux clés étrangères. Les propriétés de l'association y vont aussi.
Le résultat, en notation textuelle. La clé primaire est en gras, les clés étrangères commencent par #.
- UTILISATEUR (id_utilisateur, pseudo, email, mot_de_passe)
- ARTICLE (id_article, titre, contenu, date_publication)
- TAG (id_tag, libelle)
- COMMENTAIRE (id_commentaire, contenu, date_creation, #id_utilisateur, #id_article)
- ÉTIQUETER (#id_article, #id_tag)
- AIMER (#id_utilisateur, #id_article, date_aime)
ÉCRIRE et CONCERNER ont disparu : elles sont devenues les clés étrangères de COMMENTAIRE (règle 2). ÉTIQUETER et AIMER sont devenues des tables (règle 3).
Un dernier cas mérite d'être connu : l'association 0,1 / 1,1, une relation un à un. La clé étrangère va du côté 1,1, avec une contrainte d'unicité pour garantir qu'elle n'apparaît qu'une fois.
Les formes normales
Un MLD bien construit respecte au moins les trois premières formes normales.
- 1FN : chaque colonne contient une seule valeur. Pas de colonne tags qui vaut « php, laravel, sql »
- 2FN : en 1FN et chaque colonne dépend de toute la clé primaire. Dans AIMER, une colonne pseudo ne dépendrait que de id_utilisateur : elle n'a rien à faire là
- 3FN : en 2FN et aucune colonne ne dépend d'une autre colonne non clé. Stocker le code postal et la ville dans la même table recopie la ville à chaque fois
Un MCD correct donne en général un MLD déjà normalisé. Les formes normales servent surtout à vérifier.
Le MPD
Le MPD traduit le MLD pour un SGBD précis. On y prend des décisions qui n'existaient pas avant : types exacts, longueurs, index, comportement à la suppression, conventions de nommage.
Ici, MySQL avec les conventions de Laravel : noms en anglais, tables au pluriel, en snake_case. UTILISATEUR devient users, pseudo devient username, ÉTIQUETER devient article_tag. Renommer fait partie des décisions physiques, le modèle ne change pas.
CREATE TABLE users (
    id         BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    username   VARCHAR(30)  NOT NULL UNIQUE,
    email      VARCHAR(255) NOT NULL UNIQUE,
    password   VARCHAR(255) NOT NULL
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

CREATE TABLE articles (
    id           BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    title        VARCHAR(255) NOT NULL,
    content      LONGTEXT     NOT NULL,
    published_at TIMESTAMP    NULL
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

CREATE TABLE tags (
    id    BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    label VARCHAR(50) NOT NULL UNIQUE
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

CREATE TABLE comments (
    id         BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    content    TEXT            NOT NULL,
    created_at TIMESTAMP       NOT NULL DEFAULT CURRENT_TIMESTAMP,
    user_id    BIGINT UNSIGNED NULL,
    article_id BIGINT UNSIGNED NOT NULL,
    CONSTRAINT fk_comments_user
        FOREIGN KEY (user_id) REFERENCES users (id) ON DELETE SET NULL,
    CONSTRAINT fk_comments_article
        FOREIGN KEY (article_id) REFERENCES articles (id) ON DELETE CASCADE
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

CREATE TABLE article_tag (
    article_id BIGINT UNSIGNED NOT NULL,
    tag_id     BIGINT UNSIGNED NOT NULL,
    PRIMARY KEY (article_id, tag_id),
    FOREIGN KEY (article_id) REFERENCES articles (id) ON DELETE CASCADE,
    FOREIGN KEY (tag_id)     REFERENCES tags (id)     ON DELETE CASCADE
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

CREATE TABLE likes (
    user_id    BIGINT UNSIGNED NOT NULL,
    article_id BIGINT UNSIGNED NOT NULL,
    liked_at   TIMESTAMP       NOT NULL DEFAULT CURRENT_TIMESTAMP,
    PRIMARY KEY (user_id, article_id),
    FOREIGN KEY (user_id)    REFERENCES users (id)    ON DELETE CASCADE,
    FOREIGN KEY (article_id) REFERENCES articles (id) ON DELETE CASCADE
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;
Le même schéma, dessiné par Mermaid :
erDiagram
    users |o--o{ comments : "écrit"
    articles ||--o{ comments : "concerne"
    articles ||--o{ article_tag : "porte"
    tags ||--o{ article_tag : "étiquette"
    users ||--o{ likes : "aime"
    articles ||--o{ likes : "est aimé"

    users {
        bigint id PK
        varchar username UK
        varchar email UK
        varchar password
    }
    articles {
        bigint id PK
        varchar title
        longtext content
        timestamp published_at
    }
    comments {
        bigint id PK
        text content
        timestamp created_at
        bigint user_id FK "NULL autorisé"
        bigint article_id FK
    }
    tags {
        bigint id PK
        varchar label UK
    }
    article_tag {
        bigint article_id PK, FK
        bigint tag_id PK, FK
    }
    likes {
        bigint user_id PK, FK
        bigint article_id PK, FK
        timestamp liked_at
    }
Ce diagramme utilise la notation dite « patte de corbeau ». || veut dire exactement un, |o zéro ou un, o{ zéro ou plusieurs. Ce sont les cardinalités du MCD, placées de l'autre côté de la ligne : le |o près de users se lit « un commentaire a zéro ou un auteur ».
Chaque choix se justifie par le MCD :
user_idaccepte NULL parce que la cardinalité était 0,1ON DELETE SET NULLgarde les commentaires d'un compte supprimé, sans auteurON DELETE CASCADEsurarticle_idsupprime les commentaires avec leur article puisqu'un commentaire n'existe pas sans article- la clé primaire composée de
likesempêche d'aimer deux fois le même article utf8mb4accepte tous les caractères, y compris les emojis que les visiteurs ne manqueront pas d'écrire
Avec Laravel, le MPD s'écrit sous forme de migrations plutôt qu'en SQL brut. Le raisonnement reste exactement le même.
Et le diagramme de classes ?
Hors de France, on modélise plutôt les données avec un diagramme de classes UML ou un diagramme entité-association. Les deux approches se ressemblent, mais elles ne servent pas à la même chose.
- le MCD décrit des données et leurs liens. Rien d'autre
- le diagramme de classes décrit des objets : leurs données, mais aussi leurs méthodes, l'héritage et les interfaces
Avec un ORM, les cardinalités se retrouvent directement dans le code.
| Cardinalités du MCD | Eloquent | JPA |
|---|---|---|
| x,n / x,1 | hasMany et belongsTo |
@OneToMany et @ManyToOne |
| x,1 / 0,1 | hasOne et belongsTo |
@OneToOne |
| x,n / x,n | belongsToMany |
@ManyToMany |
| x,n / x,n avec propriétés | belongsToMany et withPivot() |
une entité dédiée avec deux @ManyToOne |
La dernière ligne est importante. Dès qu'une association porte des données, comme la date de AIMER, JPA demande une vraie entité pour la table d'association. Un @ManyToMany ne sait pas stocker de colonne en plus.
Ce qu'il faut garder en tête
La conception est un outil de discussion. Un diagramme que personne ne lit ne sert à rien. Un diagramme qui fait dire à quelqu'un « ah non, un commentaire peut exister sans compte » vient de faire gagner une semaine.
On ne fait pas tous les diagrammes pour toutes les fonctionnalités. Un formulaire de contact n'a pas besoin d'un diagramme de séquence. Une fonctionnalité qui touche au paiement, oui.
Un modèle vit avec le projet. Quand la base change, le MCD change aussi. Sinon, il ment et un document qui ment est pire que pas de document du tout.
Pour aller plus loin
- Mermaid, la syntaxe des diagrammes de cet article, que GitHub et GitLab affichent aussi directement
- Mermaid Live Editor, pour tester un diagramme et voir le rendu en direct
- PlantUML, pour la notation UML complète, y compris les vrais diagrammes de cas d'utilisation
- Looping, un logiciel gratuit pour dessiner MCD et MLD selon Merise
- La spécification UML de l'OMG, la référence officielle, à consulter plutôt qu'à lire
- User Stories Applied de Mike Cohn, le livre de référence sur les user stories
- UML Distilled de Martin Fowler, court et pragmatique
Un exercice pour finir. Prends une fonctionnalité de ton projet actuel et écris sa user story avec deux critères d'acceptation. Dessine ensuite la partie du MCD qu'elle touche. Si une cardinalité te fait hésiter, c'est une question à poser à quelqu'un avant de coder.
Commentaires (0)
Laisser un commentaire
Vous pouvez commenter en renseignant votre nom et votre email. Votre message sera publié après modération. Avec un compte, il apparaît immédiatement et reste modifiable.
Aucun commentaire pour le moment
Soyez le premier à commenter cet article !