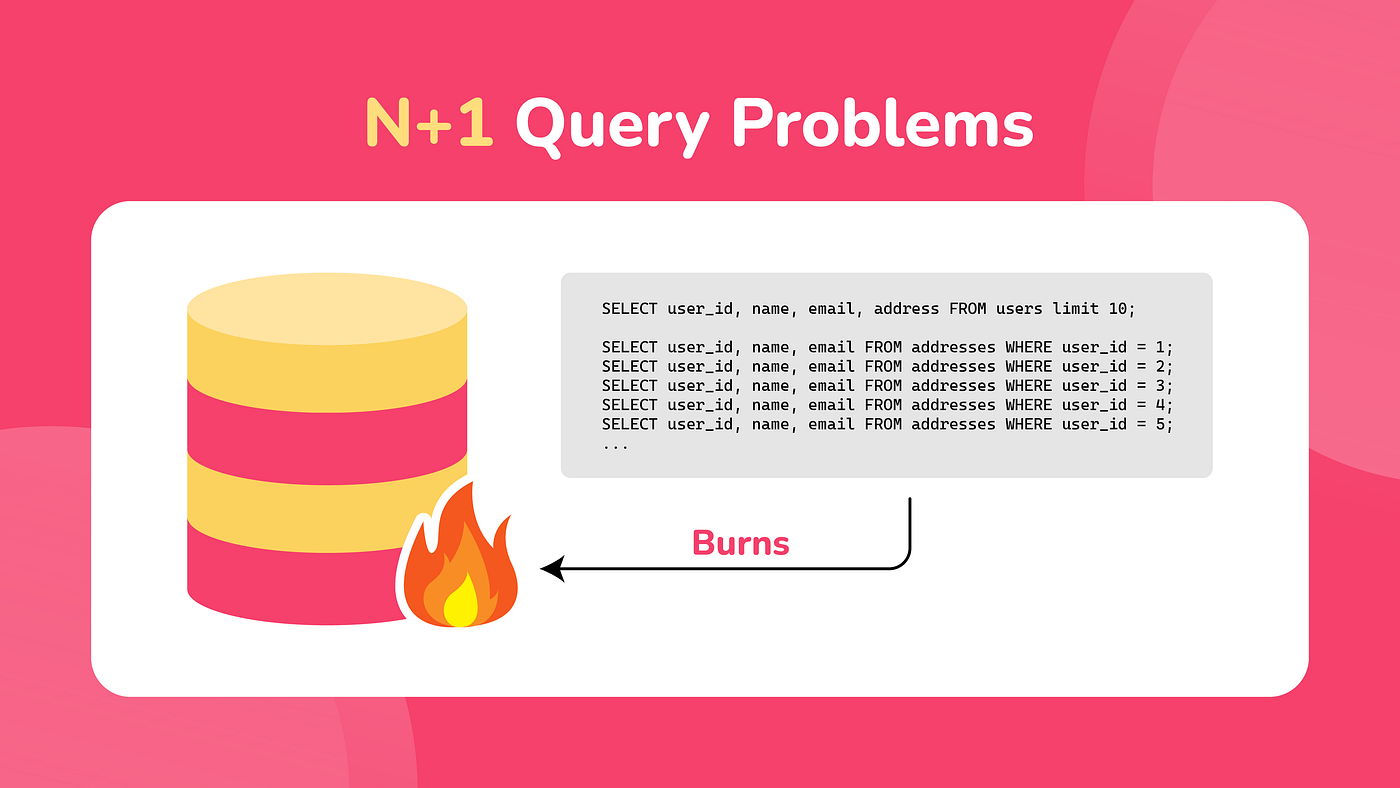
La tua applicazione funziona bene in sviluppo. La metti in produzione, arrivano i dati e una pagina che rispondeva in cinquanta millisecondi ora ne impiega quattromila. Nel codice non è cambiato nulla e il colpevole è quasi sempre lo stesso. È il problema N+1.
È il difetto di prestazioni più diffuso appena si usa un ORM. È anche uno dei più facili da correggere. Bisogna però saperlo individuare.
Che cos'è il problema N+1
Il nome viene dal numero di query inviate al database. Una query recupera un elenco di N elementi, poi una query in più per ogni elemento carica un dato collegato. In totale N + 1.
Un esempio in Laravel.
$articles = Article::all();

foreach ($articles as $article) {
    echo $article->author->name;
}
Tre righe che sembrano innocue. Ecco cosa parte davvero verso il database.
SELECT * FROM articles;

SELECT * FROM users WHERE id = 1;
SELECT * FROM users WHERE id = 2;
SELECT * FROM users WHERE id = 3;
-- e così via
Con dieci articoli, undici query. Con mille articoli, milleuno.
Ecco la trappola! In sviluppo il tuo database contiene dieci righe di prova e la pagina risponde all'istante. Il difetto resta invisibile e si mostra solo quando il volume cresce. Quindi in produzione.
Perché gli ORM producono questo difetto
Non è un bug. È la conseguenza diretta del caricamento pigro, un meccanismo voluto.
Un ORM non può indovinare ciò di cui avrai bisogno. Se caricasse tutte le relazioni ogni volta, la minima query riporterebbe metà del database. Carica quindi l'oggetto principale e aspetta che tu chieda una relazione per andarla a prendere.
$article = Article::find(1);
// Una query su articles

$article->author;
// Seconda query, scatenata da questo accesso
Su un singolo oggetto questo comportamento va bene. In un ciclo diventa un problema. Ogni giro scatena il proprio viaggio di andata e ritorno verso il database.
Il costo reale non è nemmeno il tempo di esecuzione SQL. Ogni query costa un viaggio di rete, un'analisi da parte del motore e un passaggio nello strato di connessione. Su un database remoto, un millisecondo per query diventa un secondo intero dopo mille giri.
Individuarlo prima della produzione
In Laravel
Il modo più diretto è far sollevare un errore appena una relazione viene caricata al volo.
// In AppServiceProvider::boot()
Model::preventLazyLoading(!app()->isProduction());
Fuori dalla produzione, ogni relazione non precaricata solleva una LazyLoadingViolationException. È brutale ma efficace. Non puoi più lasciar passare il difetto.
Se preferisci una versione che non rompe la pagina, scrivi nel log invece di sollevare un'eccezione.
Model::preventLazyLoading(!app()->isProduction());

Model::handleLazyLoadingViolationUsing(function (Model $model, string $relation) {
    Log::warning('Relazione caricata al volo: ' . $model::class . '::' . $relation);
});
Apri poi storage/logs/laravel.log e vedi esattamente dove sono i tuoi N+1.
Per osservare il traffico SQL reale:
DB::listen(function ($query) {
    Log::debug($query->sql, ['time' => $query->time]);
});
Anche Laravel Debugbar e Telescope mostrano il numero di query per pagina, con i duplicati segnalati.
In Spring Boot e Hibernate
Attiva le statistiche di Hibernate.
spring.jpa.properties.hibernate.generate_statistics=true
logging.level.org.hibernate.stat=DEBUG
A ogni transazione, Hibernate mostra il numero di statement preparati e il tempo impiegato. Uno scarto tra il numero di entità e il numero di query salta subito all'occhio.
Per leggere l'SQL:
spring.jpa.show-sql=true
spring.jpa.properties.hibernate.format_sql=true
Non lasciare mai queste opzioni attive in produzione. Il volume di log sarebbe ingestibile.
La libreria datasource-proxy va oltre. Permette di far fallire un test oltre un certo numero di query. È il modo migliore per evitare una regressione.
Correggere in Laravel
Il precaricamento
La soluzione di base è with().
$articles = Article::with('author')->get();

foreach ($articles as $article) {
    echo $article->author->name;
}
Due query, qualunque sia il numero di articoli.
SELECT * FROM articles;
SELECT * FROM users WHERE id IN (1, 2, 3, 4, 5);
Eloquent raccoglie gli identificativi, esegue una sola query con in e poi collega i risultati in memoria.
Le relazioni annidate
// Articolo, il suo autore, i suoi commenti e l'autore di ogni commento
$articles = Article::with('author', 'comments.user')->get();
Limitare le colonne
Caricare tutta la riga per mostrare solo un nome è uno spreco.
$articles = Article::with('author:id,name,avatar')->get();
Qui ci sono due trappole. Prima di tutto, niente spazi dopo le virgole. Eloquent divide l'elenco senza togliere gli spazi e la query fallisce su una colonna " name" inesistente.
Poi, la colonna che collega le due tabelle deve sempre comparire nell'elenco. Per un belongsTo come author, è la chiave primaria id di users: Eloquent la confronta con l'author_id dell'articolo. Senza di essa, l'autore non viene collegato a nessun articolo e la relazione torna vuota senza alcun errore. Per un hasMany è il contrario: bisogna tenere la chiave esterna della tabella figlia, per esempio article_id.
Contare senza caricare
Per mostrare il numero di commenti, non caricare i commenti.
// Sbagliato: carica tutti i commenti solo per contarli
$articles = Article::with('comments')->get();

foreach ($articles as $article) {
    echo $article->comments->count();
}

// Giusto: il conteggio lo fa il database
$articles = Article::withCount('comments')->get();

foreach ($articles as $article) {
    echo $article->comments_count;
}
withCount aggiunge una sottoquery alla query principale. Nessun oggetto inutile viene costruito lato PHP.
Le stesse varianti esistono per le aggregazioni.
$articles = Article::withSum('comments', 'score')
    ->withAvg('ratings', 'value')
    ->withExists('comments')
    ->get();
Il precaricamento condizionale
$articles = Article::with(['comments' => function ($query) {
    $query->where('is_approved', true)
        ->latest()
        ->limit(5);
}])->get();
Da Laravel 11, limit(5) si applica a ogni articolo. Prima valeva per l'intera query: cinque commenti in totale, distribuiti a caso tra gli articoli.
Caricare in un secondo momento
Quando la collezione esiste già.
$articles = Article::all();

// A seconda del contesto
if ($needsAuthors) {
    $articles->load('author');
}
loadMissing() fa la stessa cosa ignorando le relazioni già caricate.
Il precaricamento predefinito
Quando una relazione serve quasi sempre.
class Comment extends Model
{
    protected $with = ['user'];
}
Da usare con prudenza. Una relazione caricata ogni volta appesantisce tutte le query, comprese quelle che non ne hanno bisogno. Tienilo per le relazioni davvero indispensabili.
Correggere in JPA e Hibernate
Stesso principio, strumenti diversi.
La trappola dei valori predefiniti
Un punto fondamentale e spesso ignorato. JPA non ha lo stesso comportamento predefinito per ogni tipo di relazione.
| Annotazione | Caricamento predefinito |
|---|---|
@OneToMany |
LAZY |
@ManyToMany |
LAZY |
@ManyToOne |
EAGER |
@OneToOne |
EAGER |
Le ultime due righe sono il problema. Un @ManyToOne in EAGER significa che caricare un'entità carica anche il suo genitore ogni volta, anche quando non ti serve. Su un'entità con diverse relazioni @ManyToOne, una sola lettura può scatenare una cascata di join.
Tutti consigliano la stessa cosa: metti tutto in LAZY e poi carica esplicitamente ciò che ti serve.
@Entity
public class Article {

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "author_id")
    private User author;

    @OneToMany(mappedBy = "article", fetch = FetchType.LAZY)
    private List<Comment> comments;
}
JOIN FETCH
L'equivalente diretto del with() di Laravel.
@Query("""
    SELECT a FROM Article a
    JOIN FETCH a.author
    WHERE a.publishedAt IS NOT NULL
    """)
List<Article> findPublishedWithAuthor();
Attenzione alla differenza tra join e join fetch. Un join semplice serve a filtrare e non carica la relazione. Solo join fetch la porta in memoria.
Gli entity graph
Più flessibili, separano la query dalla strategia di caricamento.
@Entity
@NamedEntityGraph(
    name = "Article.withAuthorAndComments",
    attributeNodes = {
        @NamedAttributeNode("author"),
        @NamedAttributeNode("comments")
    }
)
public class Article { }
public interface ArticleRepository extends JpaRepository<Article, Long> {

    @EntityGraph(value = "Article.withAuthorAndComments")
    List<Article> findByPublishedAtIsNotNull();
}
Il vantaggio è netto. La strategia di caricamento è separata dalla query. Uno stesso graph serve a più metodi, e una query derivata come findByPublishedAtIsNotNull non deve essere riscritta in JPQL per caricare le sue relazioni.
Il caricamento a blocchi
Una soluzione intermedia, molto efficace e spesso dimenticata.
spring.jpa.properties.hibernate.default_batch_fetch_size=25
Hibernate raggruppa allora i caricamenti pigri a blocchi. Invece di cento query, ne invia quattro con un in di venticinque identificativi. Non si passa da N+1 a 1, si passa da N+1 a N/25 + 1. Nella maggior parte dei casi basta e avanza.
L'annotazione @BatchSize permette la stessa impostazione relazione per relazione.
Le proiezioni DTO
La soluzione più veloce quando devi solo leggere.
public record ArticleSummary(Long id, String title, String authorName) { }
@Query("""
    SELECT new com.blog.dto.ArticleSummary(a.id, a.title, a.author.name)
    FROM Article a
    """)
List<ArticleSummary> findAllSummaries();
Una sola query e solo le colonne utili. Nessuna entità gestita dal contesto di persistenza. Per una pagina di elenco in sola lettura, è spesso la scelta migliore.
Le trappole tipiche di Hibernate
Tre errori classici che sorprendono tutti almeno una volta.
MultipleBagFetchException
// Solleva un'eccezione all'avvio
@Query("""
    SELECT a FROM Article a
    JOIN FETCH a.comments
    JOIN FETCH a.tags
    """)
Hibernate rifiuta di caricare due collezioni di tipo List nella stessa query. Il messaggio è chiaro, la causa meno. Una List senza indice conserva i duplicati. Due join darebbero un risultato ambiguo.
Tre soluzioni: sostituire List con Set, eseguire due query separate (il contesto di persistenza riunisce i risultati da solo) oppure mettere @BatchSize sulla seconda collezione.
Il prodotto cartesiano
Anche con dei Set, due join fetch su collezioni producono un prodotto cartesiano nel database. Un articolo con venti commenti e cinque tag restituisce cento righe SQL. Hibernate elimina i duplicati in memoria, ma le cento righe hanno attraversato la rete.
In pratica, una sola collezione per query. Le altre passano da @BatchSize o da una query separata.
Paginazione e JOIN FETCH
Questo avviso è il più pericoloso di tutti perché il codice funziona lo stesso. Si chiama HHH000104 con Hibernate 5 e HHH90003004 con Hibernate 6, quello di Spring Boot 3.
@Query("SELECT a FROM Article a JOIN FETCH a.comments")
Page<Article> findAll(Pageable pageable);
Hibernate non può applicare limit in SQL. Il join moltiplica le righe e un limite taglierebbe le collezioni a metà. Carica quindi tutta la tabella e poi pagina nella memoria Java.
Con mille articoli, la tua pagina da venti elementi ne carica mille. Nessun errore, solo un'applicazione che crolla appena il volume cresce.
Per non lasciarlo più passare, trasforma l'avviso in errore.
spring.jpa.properties.hibernate.query.fail_on_pagination_over_collection_fetch=true
La soluzione consiste nel dividere il lavoro in due passaggi.
// 1. Recuperare gli identificativi della pagina senza join
@Query("SELECT a.id FROM Article a ORDER BY a.publishedAt DESC")
Page<Long> findPageOfIds(Pageable pageable);

// 2. Caricare queste entità con le loro collezioni, nello stesso ordine
@Query("SELECT a FROM Article a JOIN FETCH a.comments WHERE a.id IN :ids ORDER BY a.publishedAt DESC")
List<Article> findAllWithCommentsByIds(@Param("ids") List<Long> ids);
L'ORDER BY della seconda query non è decorativo. Una clausola IN non garantisce alcun ordine: senza di esso, la pagina torna mescolata.
L'eccesso opposto
Correggere un N+1 non significa precaricare tutto.
// Costoso e probabilmente inutile
$articles = Article::with([
    'author.profile.settings',
    'comments.user.roles',
    'tags',
    'category.parent',
])->paginate(15);
Se la tua vista mostra solo il titolo e il nome dell'autore, tutto il resto è trasferimento e memoria buttati via. Una sola grande query può essere più lenta di alcune piccole.
La regola sta in una frase: precarica esattamente ciò che la vista usa, non ciò che potrebbe servirle un giorno. Il precaricamento risponde a un bisogno constatato. Non è una precauzione.
Un metodo di lavoro
Quattro passaggi, in quest'ordine.
Misura prima: Conta le query della tua pagina. In Laravel, Debugbar lo mostra. In Spring, le statistiche di Hibernate lo forniscono. Senza misurare, ottimizzi alla cieca.
Rendi visibile il difetto: preventLazyLoading in Laravel, una soglia di query nei test in Spring. Un difetto segnalato dallo strumento non può più tornare di nascosto.
Correggi nel posto giusto: Il precaricamento si dichiara nel controller o nel repository, mai nella vista. Una vista non dovrebbe mai scatenare una query.
Verifica dopo: Conta di nuovo. Passare da centouno query a due si constata, non si suppone.
Commenti (0)
Lascia un commento
Puoi commentare indicando il tuo nome e la tua email. Il messaggio sarà pubblicato dopo la moderazione. Con un account appare subito e resta modificabile.
Ancora nessun commento
Sii il primo a commentare questo articolo!